エンジニアの佐野です。Synapse という社内 AI エージェントを運用しています。Synapse のような AI エージェントは LLM やプロンプト、セマンティックレイヤーの変更によって回答品質が急に落ちることがあります。そこで今回は、Synapse の回答品質を継続的に評価するために、SQL の Execution Accuracy、参照テーブルの完全一致、自然言語回答の Rubric 評価を組み合わせたテスト基盤を作った話を書きます。目的は LLM の回答を100%正しくすること、ではなく、利用者にとって困るデグレを早く検知すること、です。
生成 AI は出力に不確実性を孕んでおり、その評価が重要になるということは過去に何度か言及しています。「Synapse開発日記: LLM 切り替えで露呈する社内 AI エージェントのモデル依存性 - カンム テックブログ」ではモデルの変更により、期待通りの生成がされなくなることに言及しています。「社内 AI エージェント Synapse と セマンティックレイヤーの育て方というタイトルで登壇しました+補足 - カンム テックブログ 」では Text-to-SQL の評価手法の1つとして Execution Accuracy について述べました。
手元で何か作業をするのであれば期待通りの生成がされるように何度も軌道修正すればよいですが、例えば顧客向けのアプリケーションの裏に LLM を組み込んで応答を生成している場合、極端に的を外した回答を生成されては困る場合があります。しかしながら生成 AI はその性質上、百発百中で狙い通りの回答をしてくれるとは限りません。このくらいの品質であれば OK 、それを下回ったら NG というような閾値を決め、その閾値となる品質を満たしているかどうかを検査します。まず目指すゴールとしては、急なデグレを検知できる仕組みを作ろう、というものです。
今日はその品質評価のテストをどう回すか?ということについて書いていきます。記事の主眼としては生成される SQL (Text-to-SQL) の精度およびユーザの質問に対して生成される回答の評価 (Rubric評価) に主眼を置いています。
過去シリーズは次にまとまっています。
- データ分析を加速する AI エージェント Synapse の開発と運用 - カンム テックブログ
- 社内 AI エージェント Synapse を MCP サーバ化して Entra ID で認証する - カンム テックブログ
- 手元のAIエージェントから SageMaker AI Studio の Jupyter を直接操作できるようにした話 - カンム テックブログ
- 社内 AI エージェント Synapse と セマンティックレイヤーの育て方というタイトルで登壇しました+補足 - カンム テックブログ
- Synapse開発日記: LLM 切り替えで露呈する社内 AI エージェントのモデル依存性 - カンム テックブログ
- Synapse開発日記: Google ADKのコンパクションで社内AIエージェントのコストを抑える - カンム テックブログ
0. Synapse について
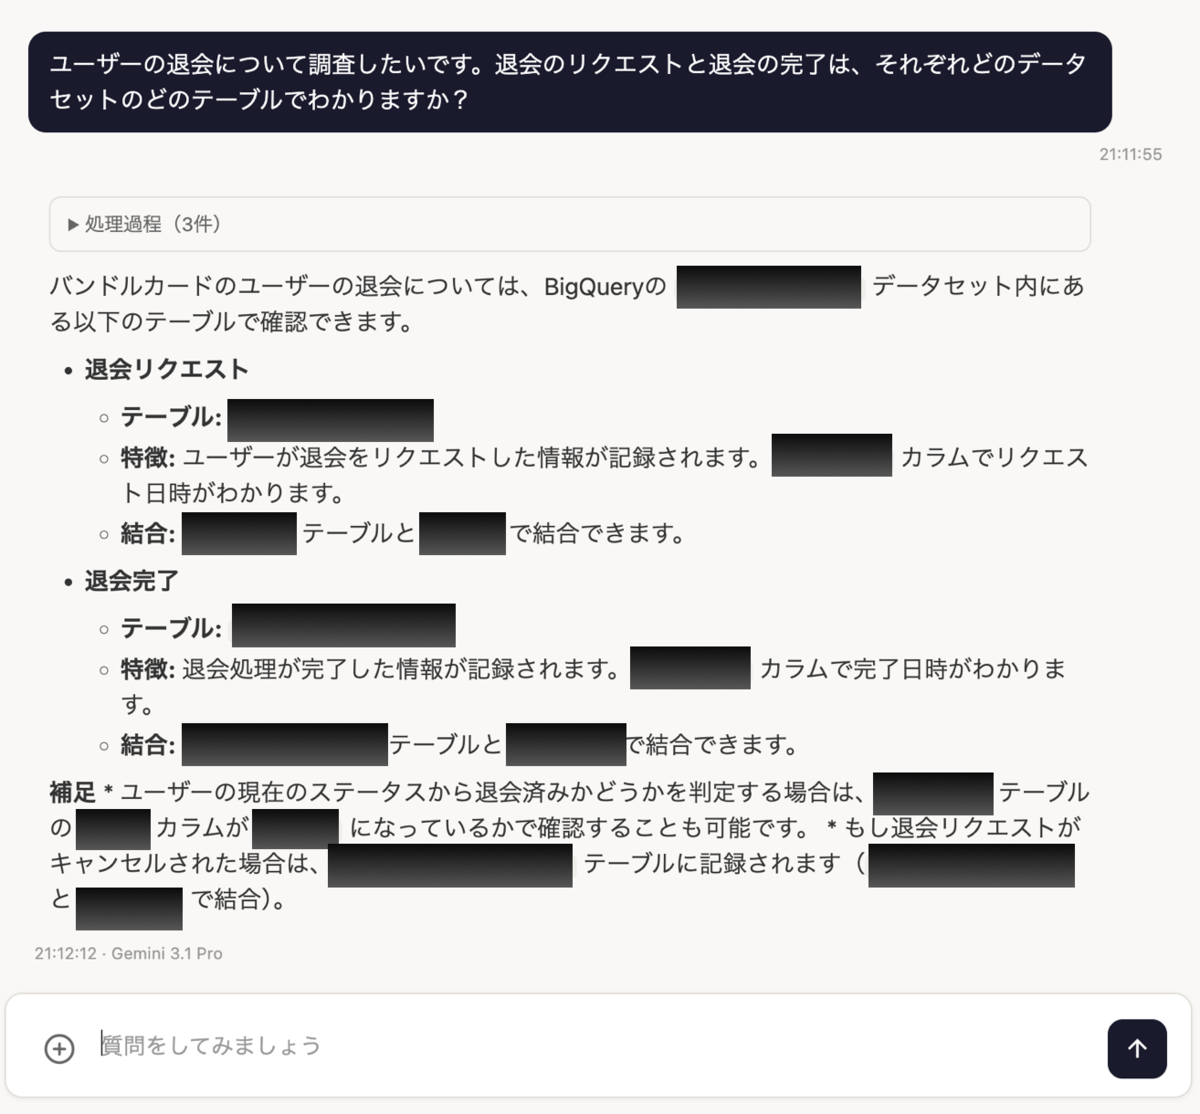
ブラウザや Claude Code や Codex などから接続して質問や作業を投げることができます。質問内容は LLM によって解釈され、社内のナレッジを参照して BigQuery にクエリしたりソースコード参照を行い、応答を返します。例えば次のようなプロダクト固有の質問をすると業務を理解して応答してくれます。
1. 生成の入力と出力の整理
モデルの変更、Synapse のソースコードの修正、セマンティックレイヤーの修正、ツールの description の編集...様々な要因によって生成の精度が低下することがあります。ではその生成の精度をどう評価するか?
ソフトウェアでいうとテストに該当するようなものです。テストと言えば入力に対して期待する出力がありそれをチェックします。それと同様です。よってここで Synapse への入力となるパラメータと出力を整理します。以下のようになっています。
入力
- システムプロンプト
- ユーザプロンプト
- 利用するモデル
出力
- 中間応答
- 最終応答
システムプロンプトとユーザプロンプト、利用するモデルがインプットとなります。これを Synapse 経由で LLM が呼び出されて生成が行われます。ツール定義やセマンティックレイヤーも入力にあると思うかもしれませんが、それを使うかどうかは上記入力をもとに LLM が決めることです。出力には2つのフェーズがあり、中間応答と、ユーザに返される最終応答があります。ここで中間応答とは、AI エージェントである Synapse がユーザからのプロンプトを受け、最終的な出力を返すまでに何度か LLM とやりとりをしたり、ツール呼び出しを行うフェーズです。Synapse が利用している AI エージェントフレームワークである Google ADK のシーケンスについては「Synapse開発日記: Google ADKのコンパクションで社内AIエージェントのコストを抑える - カンム テックブログ」の「1. Google ADK の挙動」で示しました。その記事内での説明の 1 invocation 内で何度か実行される LLM Call がその中間応答に該当します。1 invocation の最後の LLM Call の応答が最終応答です。この挙動は他のハーネスでも同様かと思われます。
2. Synapse の品質評価とその評価システムの実装
Synapse の品質評価では入力に対し、最終応答が期待通りになっているかを検査します。中間応答で期待通りのツール呼び出しがされるか?狙い定めたセマンティックレイヤーが参照されているか?といった、最終応答に至るまでのステップが期待通りかどうかをチェックする手段もありますが、今は最終的な出力のみを評価対象としています。そしてその最終応答の中でも以下のものをターゲットにしています。
- 生成される SQL の正確さ
- データ分析において参照すべきテーブルの正確さ
- 生成される回答の品質
これらをターゲットとしているのは、本記事の題材である Synapse がデータ分析を支援するツールとしてスタートしたためです。SQL や参照すべきテーブルの正確さに重きを置いています。
その評価システムの実装について簡単に書くと、実態は単純な Python のスクリプトです。テストケースと期待値は yaml で記述されています。スクリプトで yaml を読み込み、その内容を Synapse に送信して取得られた応答を期待値と照合します。概ね次のようなフォーマットです。
- question: |
      {{ ユーザプロンプトに該当する質問 }}
  answer:
  - value: |
      {{ 期待値 }}
    mode: {{ sql, exact, rubric のいずれか }}
question が Synapse に投げかける質問でユーザプロンプトに該当します。他の入力値であるシステムプロンプトとモデルは Synapse 自体に記述されています。 mode はそのテストケースがどの評価を行うかを表していて、sql, exact, rubric の3つの値を取ります。sql だったら SQL の Execution Accuracy 、exact だったらテーブル名、rubric だったら自然言語の回答、を評価します。
YAML を読み込む
        │
        ├── question を Synapse に送信
        │
        ├── 最終応答を取得
        │
        └── mode ごとの評価器へ
              ├── sql     : 事前に準備した SQL の実行結果を期待値と照合
              ├── exact   : 得られたテーブル名を期待値と照合
              └── rubric  : LLM as a Judge で採点
                         │
                       集計・レポート
以下、それぞれについて書いていきます。
2.1 生成される SQL の正確さ
何回か述べているとおり Execution Accuracy で評価します。Execution Accuracy については「社内 AI エージェント Synapse と セマンティックレイヤーの育て方というタイトルで登壇しました+補足 - カンム テックブログ」を参照してください。yaml は次のように記述します。
- question: |
    2025年5月にOrganic経由だった会員登録イベントの件数
  answer:
    - value: |
      select count(*) as cnt
      from xxxx
      where xxx
      and TIMESTAMP_COLUMN_at >= TIMESTAMP("2025-05-01", "Asia/Tokyo")
      and TIMESTAMP_COLUMN_at < TIMESTAMP("2025-06-01", "Asia/Tokyo")
    mode: sql
「2025年5月にOrganic経由だった会員登録イベントの件数」を Synapse に投げて応答を得ます。value は SQL になっていますが、これは正解となる SQL の一例で、Synapse からの応答を得た後に Python スクリプトが直接 DB にクエリします。そして得られた結果を照合します。Execution Accuracy は LLM がどのような SQL を投げたかどうかには関与せず、結果だけを照合します。完全一致していればこのテストはパスとします。
2.2 データ分析において参照すべきテーブルの正確さ
「xxx に関するメッセージってどのテーブルに入っていますか?データセット名とテーブル名を教えてください。」という入力に対して、そのデータセット名とテーブル名を正確に答えられるか?を評価します。こちらも question はユーザプロンプトと同等です。mode はこの評価が参照すべきテーブルの正確さを評価するものであるということを示しています。
- question: |
    xxx のメッセージってどのテーブルに入っていますか?
    データセット名とテーブル名を教えてください。
  answer:
  - key: dataset_name
    value: EXPECTED_DATASET_NAME
  - key: table_name
    value: EXPECTED_TABLE_NAME
    mode: exact
これについても完全一致で評価します。
2.3 生成される回答の品質
「ユーザーの退会について調査したいです。退会のリクエストと退会の完了はどう調査しますか?」という質問に対し、自然言語で回答してもらいます。回答の評価は別途 LLM を呼び出してそちらに評価させます。自然言語の回答が value で示したポイントを抑えているかどうかを LLM as a Judge させます。
- question: |
    ユーザーの退会について調査したいです。
    退会のリクエストと退会の完了は、それぞれどのデータセットのどのテーブルでわかりますか?
  answer:
    - value: |
      以下の点を含むこと:
      - 退会リクエストは TABLE_NAME_1 テーブルでわかる
      - 退会完了は TABLE_NAME_2 テーブルでわかる
      - データセットは DATASET_NAME である
    mode: rubric
これについては評価用の LLM に点数をつけさせます。
3. この評価システムをいつ回すか
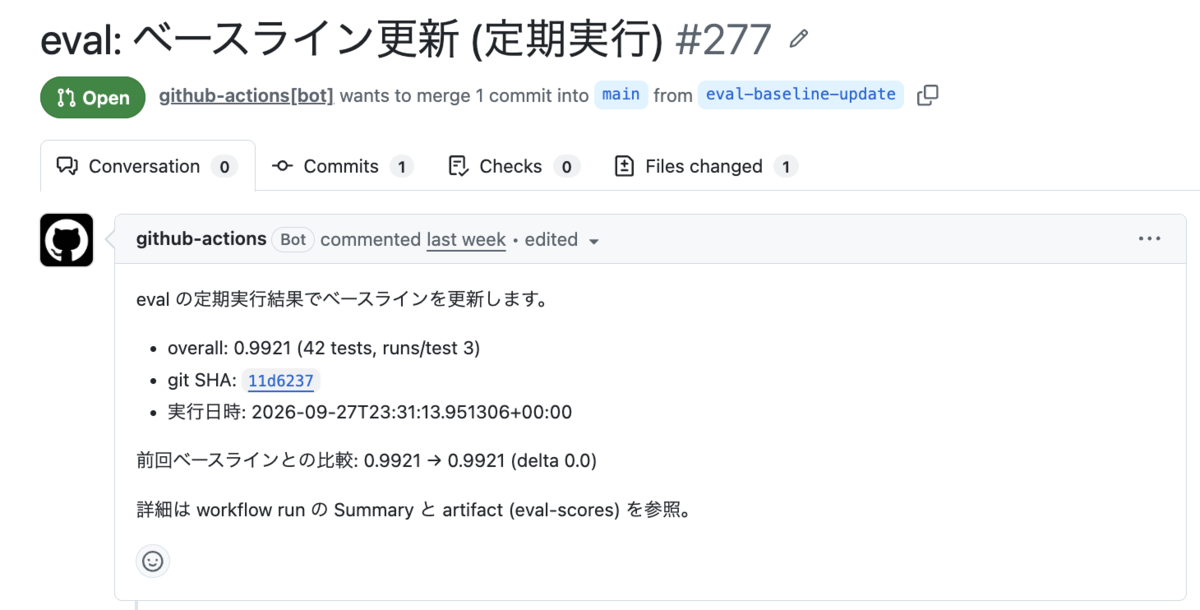
Synapse への PR のたびに回す、セマンティックレイヤー更新のたびに回す、定期的に回す...といろいろな案を考えたのですが、今は毎週1回 GitHub Actions で回しています。点数と結果レポートは PR の形で Synapse のリポジトリに格納し、点数が前回から何パーセントか下回ったら issue を立てるというやりかたです。
CI に組み込むのを考えたのですが、すべてのテストケースで LLM 呼び出しが必須になるためテストに結構な時間がかかるというのと、仮になんらかの緊急パッチが必要であるにも関わらず点数が合格点に満たなくて CI で落とされたら厳しいのでなんらかのゲートを設けるようなことはしておらず、定期的に回して issue で警告を発するようなやりかたとしました。
4. テスト設計の考慮ポイント
得られた知見です。
悪いテスト
テストに書いた質問自体が適切かどうかがなんとも言えません。良いテストになっているかどうか...しかし悪いテストというのは明確にあります。例えば、以下のようなものです。
transaction テーブルを参照して 2025年度の決済の件数を count してください。
status カラムが success および accepted のものが対象です。
これの何が悪いかというと「質問自体が答えになっている」ためです (※ transaction テーブルおよび status カラムは例のための架空の存在です)。セマンティックレイヤーにはどのように決済件数を調べるべきか、どのテーブルにどのようなデータが入っているかが記載されています。ここでもしセマンティックレイヤーをごっそり削除したとします。そうなった場合、Synapse は決済の調査方法がわからず、LLM が自力でそれっぽいテーブルを探すことになります。セマンティックレイヤーが削除されたとしても、テーブル名やカラム名が良ければ LLM が正解を引き当てるかもしれませんが、このような場合は「わからない」もしくは「集計ミス」が得られるはずです。しかしこのテストは質問自体にやり方が書いてあるためおそらくはこのテストはパスできてしまいます。これではセマンティックレイヤーの品質担保に寄与できません。あえて曖昧に書いた方が良いと言えます。
LLM as a Judge の怪しさ
不確実性に不確実性を重ねて本当にちゃんと評価できているのか?仕組みを考えると評価自体の再現性が低下する手法です。LLM as a Judge する Rubric 評価については人間もある程度見た方が良いです。
100点は目指さない
現在は用意したテストケースについては99%くらいの正解率です。再三書いてある「不確実性」を免罪符にしたくはないのですが、致命的なミスでなければよしとします。
5. 得られたことと今後
現時点では最終応答を対象にした評価で急なデグレを検知できるようになりました。
- LLM の品質評価に関する知見が得られた
- モデルアップグレード時や変更時など、大きな変化があるときの品質劣化を検知できるようになった
- 品質評価手法のベースができたので顧客向けアプリケーション組み込みの布石になった
今後ですが、最終回答だけでなく期待するツールが使われたか、参照すべきナレッジに到達できたか、生成した SQL が安全に実行できるか、といった途中経過の評価も検討しています。この場合、途中経過の期待を固定しすぎると、別解まで不正解になってしまうのですが...。
本記事中でソフトウェアのテストのようなものとも書きましたが、冒頭で述べたとおり趣旨としては正解率を100%にするための仕組みではなく、利用者にとって困る変化を早く見つけるためのフィードバックループだと考えています。
まだまだ手探りな領域だと思うので今後も掘っていこうと思います。
おわり
